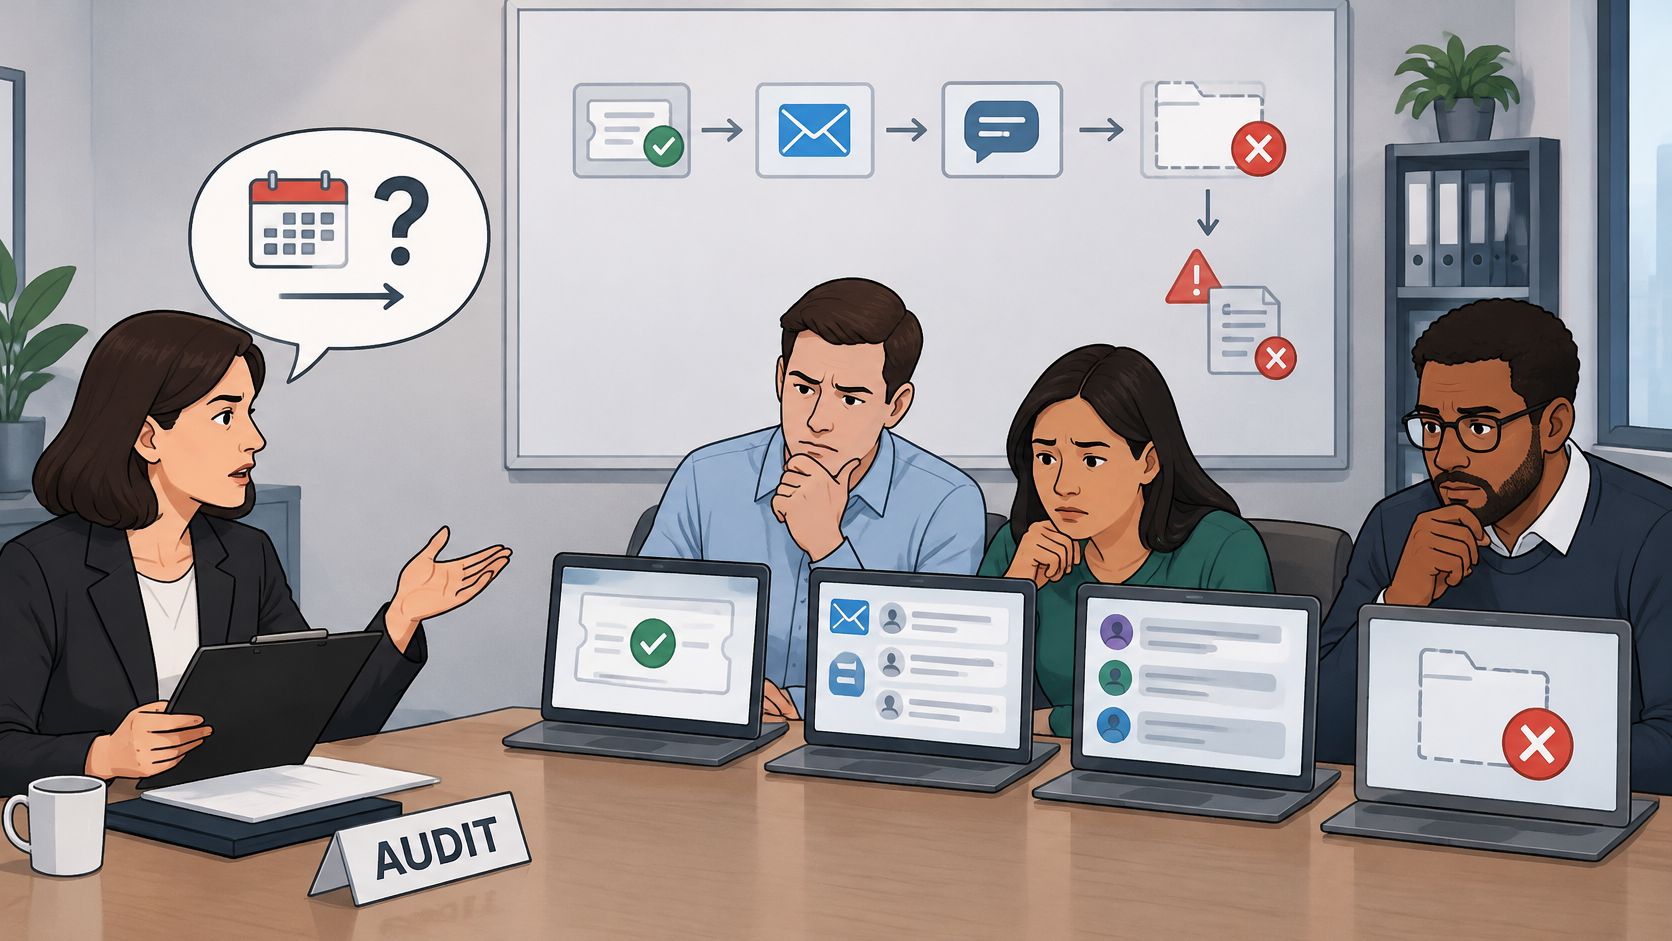
Tre mesi dopo un incidente, un auditor chiede la sequenza completa delle decisioni. Il team ritrova un ticket chiuso con la nota risolto, una catena di e-mail, messaggi in chat e uno screenshot senza data. Il lavoro tecnico probabilmente è stato svolto, ma nessuno riesce a dimostrare chi ha classificato l'evento, quando è stato contenuto, chi ha approvato la notifica e con quale evidenza. È in quel momento che la scelta di un incident response software smette di riguardare la velocità del ticketing e inizia a riguardare la prova difendibile.
Indice
- Perché un evento registrato male diventa una non conformità
- Evento, incidente e non conformità da distinguere
- Le funzioni che un software di incident response deve coprire
- Il flusso operativo dalla rilevazione alla chiusura
- Scadenze di notifica e timestamp da conservare
- Criteri per scegliere e verificare una piattaforma
- Errori comuni che indeboliscono l'audit
- Domande frequenti
- Verificare il registro prima del prossimo audit
Perché un evento registrato male diventa una non conformità
Il problema non è quasi mai l'assenza di attività. È l'impossibilità di collegare attività, decisioni e scadenze in un'unica sequenza verificabile. Un ticket può dimostrare che qualcuno ha aperto una pratica, non che il controllo ha funzionato, che l'impatto è stato valutato o che la remediation è stata verificata.
La catena che l'auditor ripercorre
La catena probatoria parte dal requisito o dall'obbligo applicabile, passa al controllo operativo, al suo owner, a un'evidenza datata e verificabile e a un audit trail immutabile. Se il controllo fallisce, la catena continua con il finding, la scadenza e la remediation verificata. Quando manca un anello, l'auditor non contesta soltanto la gestione tecnica. Contesta l'affidabilità del processo, perché non può stabilire se la decisione era motivata e tempestiva.
Questo articolo ha un taglio operativo, non legale. L'interpretazione degli obblighi NIS2 secondo il D.Lgs. 138/2024, DORA, GDPR o Modello 231 spetta al legale interno e ai consulenti incaricati. Il responsabile compliance deve invece garantire che decisioni, ruoli ed evidenze restino ricostruibili, anche nel collegamento con il registro delle non conformità.
La distinzione è visibile anche nei numeri nazionali. Secondo il resoconto sugli eventi cyber del CSIRT Italia nel primo semestre 2025, sono stati registrati 1.549 eventi cyber, il 53% in più rispetto allo stesso periodo del 2024, mentre 346 sono stati classificati come incidenti con impatto confermato, con una crescita del 98%. Molti eventi, quindi, non diventano incidenti. Il registro deve dimostrare perché, caso per caso.
Un incidente chiuso tecnicamente non è ancora un incidente chiuso ai fini dell'audit. Serve una timeline che colleghi rilevazione, classificazione, contenimento, ripristino ed evidenze.
Le pagine seguenti definiscono categorie, funzioni, flusso con ruoli, timestamp da conservare e criteri di scelta. Il criterio di fondo resta uno solo, ossia quanto rapidamente il sistema produce una prova documentale coerente.
Evento, incidente e non conformità da distinguere
Durante il triage, usare un'unica etichetta per ogni segnalazione produce due errori opposti. Alcuni eventi vengono trattati come compromissioni prima che l'impatto sia confermato, altri spariscono come rumore senza una motivazione conservata. Le cinque categorie seguenti vanno tenute separate anche quando nascono dallo stesso caso.
| Categoria | Definizione operativa | Chi decide | Evidenza minima |
|---|---|---|---|
| Evento rilevato | Segnalazione da SIEM, EDR, utente o fonte esterna, ancora da valutare | Analista di primo livello | Log originale con timestamp e fonte |
| Incidente operativo | Evento con impatto confermato su servizio, dato o sistema | Responsabile incidenti, con verifica di un secondo ruolo | Classificazione motivata, analisi di impatto, timeline |
| Incidente notificabile | Incidente che rientra nei criteri NIS2, DORA o di un altro obbligo | Referente compliance, con approvazione del DPO o del legale interno quando previsto | Calcolo della scadenza, copia della notifica, ricevuta di invio |
| Non conformità o finding | Carenza emersa da audit, test o incidente, da trattare con piano di rimedio | Owner del controllo e Internal Audit per la chiusura | Azione correttiva, scadenza, prova di chiusura verificata |
| Eccezione autorizzata | Deroga temporanea a un controllo, con motivazione e termine | Risk owner, con informativa all'OdV quando rilevante | Decisione firmata, data di scadenza, rischio residuo documentato |
Perché la separazione non è formalismo
La relazione annuale ACN 2025 riportata da Avviso Pubblico indica che nel 2025 il CSIRT Italia ha trattato 2.729 eventi cibernetici, circa il 38% in più rispetto al 2024, a fronte di 615 incidenti con impatto confermato, in crescita del 7%. Tra eventi osservati e incidenti confermati restano 2.114 casi. Applicare a tutti la stessa severità renderebbe il registro inutilizzabile e gonfierebbe le notifiche, mentre archiviarli senza motivazione impedirebbe di dimostrare il triage.
Si consideri un alert EDR su un endpoint usato da un fornitore. All'inizio è un evento rilevato. Diventa incidente operativo solo quando l'analisi conferma un accesso non autorizzato o un effetto su un servizio. Diventa notificabile se sono soddisfatti i criteri del quadro applicabile e se la decisione è approvata dal ruolo competente. Genera poi un finding se, per esempio, il controllo sull'accesso remoto del fornitore non risulta documentato o verificato.
L'eccezione autorizzata segue un'altra logica. Se il fornitore deve mantenere temporaneamente un accesso diverso dalla procedura, il risk owner può autorizzare una deroga con controlli compensativi e termine preciso. Non è un incidente e non è un finding. Va quindi registrata separatamente, pur restando collegata al caso che l'ha resa necessaria.
Le funzioni che un software di incident response deve coprire
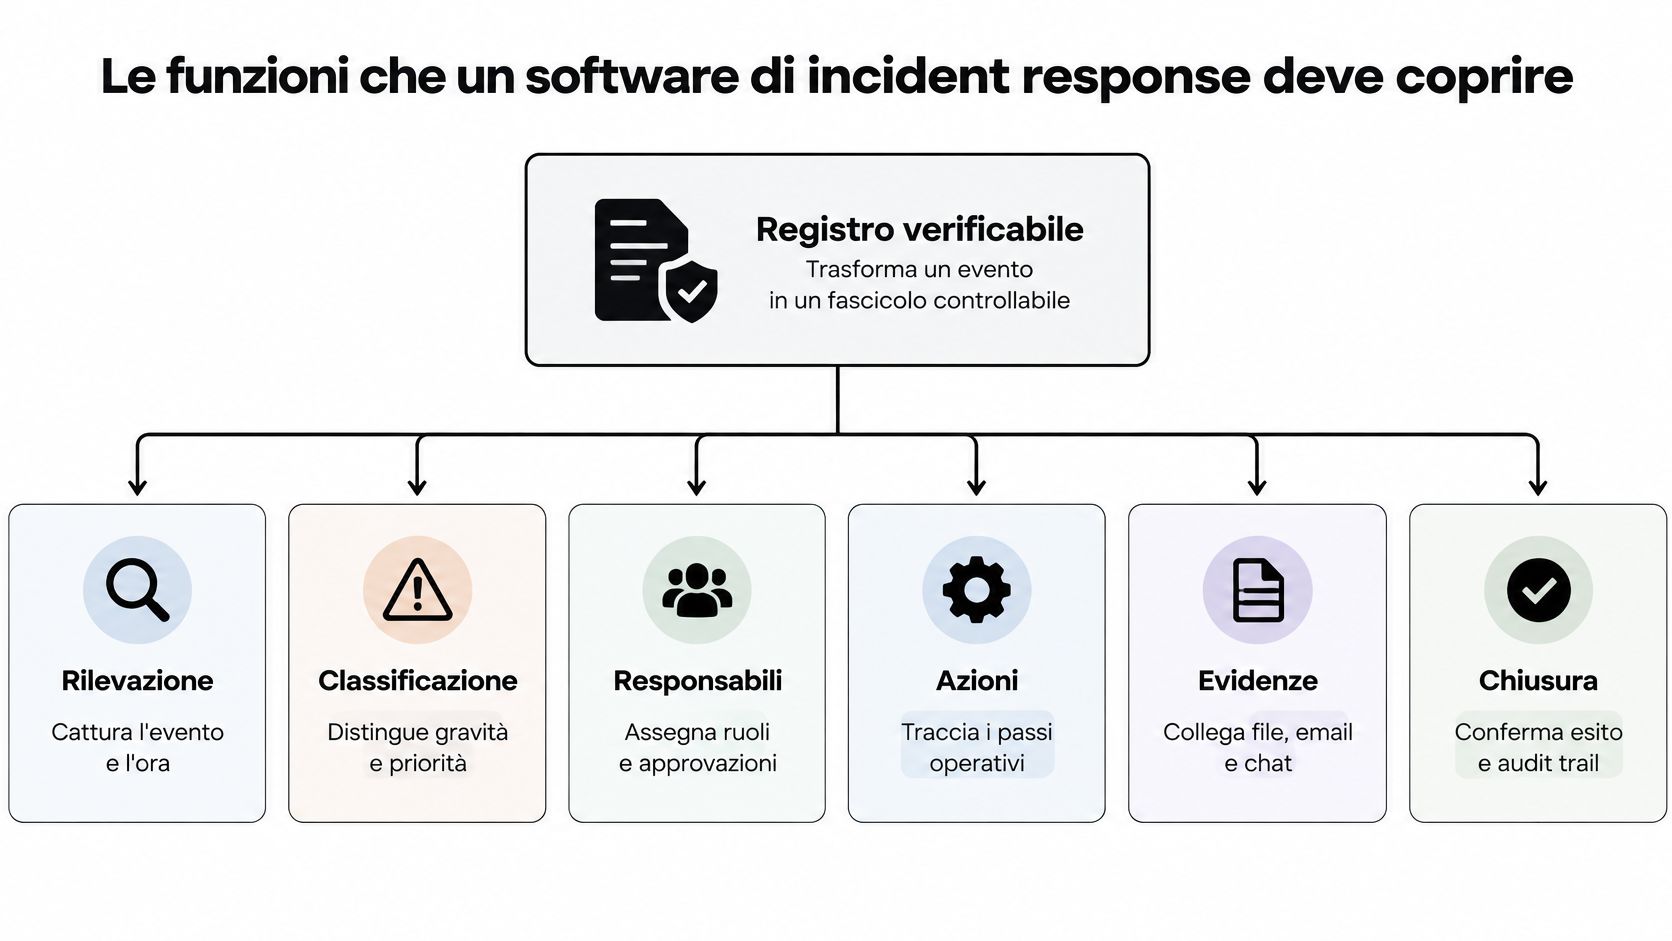
Un software di incident response utile in audit è il registro che trasforma un evento in un fascicolo verificabile. Collega rilevazione, classificazione, responsabili, contenimento, notifiche, fornitori, controlli, finding ed evidenze. Uno strumento che si limita ad assegnare ticket e stati sposta il lavoro senza renderlo difendibile: quando l'auditor chiede chi ha deciso, quando e con quale motivazione, la risposta deve essere già nel caso e non in una chat da ricostruire. Il criterio decisivo è quanto rapidamente il team produce una timeline completa di ruoli, scadenze e ragioni delle scelte.
Le funzioni in ordine di dipendenza
- Acquisizione strutturata. Segnalazioni da SIEM, EDR, mailbox, utenti e fonti istituzionali entrano con fonte, timestamp e identificativo originale. La deduplicazione evita che lo stesso alert produca più casi scollegati.
- Triage motivato. La priorità considera asset critico, riservatezza, integrità, disponibilità e dipendenze ICT. Il sistema conserva analista, categoria proposta, motivazione e verifica del secondo ruolo.
- Gestione degli indicatori di compromissione. Hash, domini e indirizzi devono avere fonte, versione, timestamp e collegamento ad asset, endpoint, fornitori e azioni di contenimento.
- Timeline immutabile ed esportabile. Rilevazione, classificazione, escalation, contenimento, comunicazioni, ripristino e lesson learned devono restare nella sequenza in cui sono stati registrati. L'esportazione serve a consegnare il fascicolo a un revisore senza ricostruirlo a mano.
- Collegamento alla governance. Ogni caso deve poter generare o richiamare controlli, rischi residui, fornitori, finding, azioni correttive e scadenze, senza ricopiare le informazioni in registri separati.
- Registri distinti per esercitazioni e casi reali. Una simulazione può generare apprendimento e finding, ma non deve alterare le statistiche o le evidenze degli incidenti operativi.
Il volume degli indicatori spiega perché le descrizioni manuali non bastano. Il report CERT-AGID sulle campagne malevole del 2025 ha censito 3.620 campagne malevole e distribuito 51.530 indicatori di compromissione a soggetti pubblici e privati. Un IoC non è già prova di compromissione, ma deve diventare ricercabile e collegabile all'asset esposto e alla decisione presa.
In AuditReady le esercitazioni e gli incidenti operativi restano in due registri separati, entrambi con apprendimento, finding ed evidenze. I finding provenienti da audit, incidenti, test, privacy o inserimento manuale confluiscono con severità, responsabile, scadenza, intervento ed evidenza di chiusura. L'audit trail delle operazioni critiche sostiene la catena probatoria, ma la classificazione resta firmata dal responsabile incidenti: nessuna funzione automatica sostituisce la decisione motivata di un ruolo competente.
Il flusso operativo dalla rilevazione alla chiusura
Il flusso deve impedire che urgenza e abitudine eliminino la verifica. Ogni fase registra almeno data, persona, decisione ed evidenza. Chi propone non approva, chi esegue non verifica da solo il proprio lavoro.
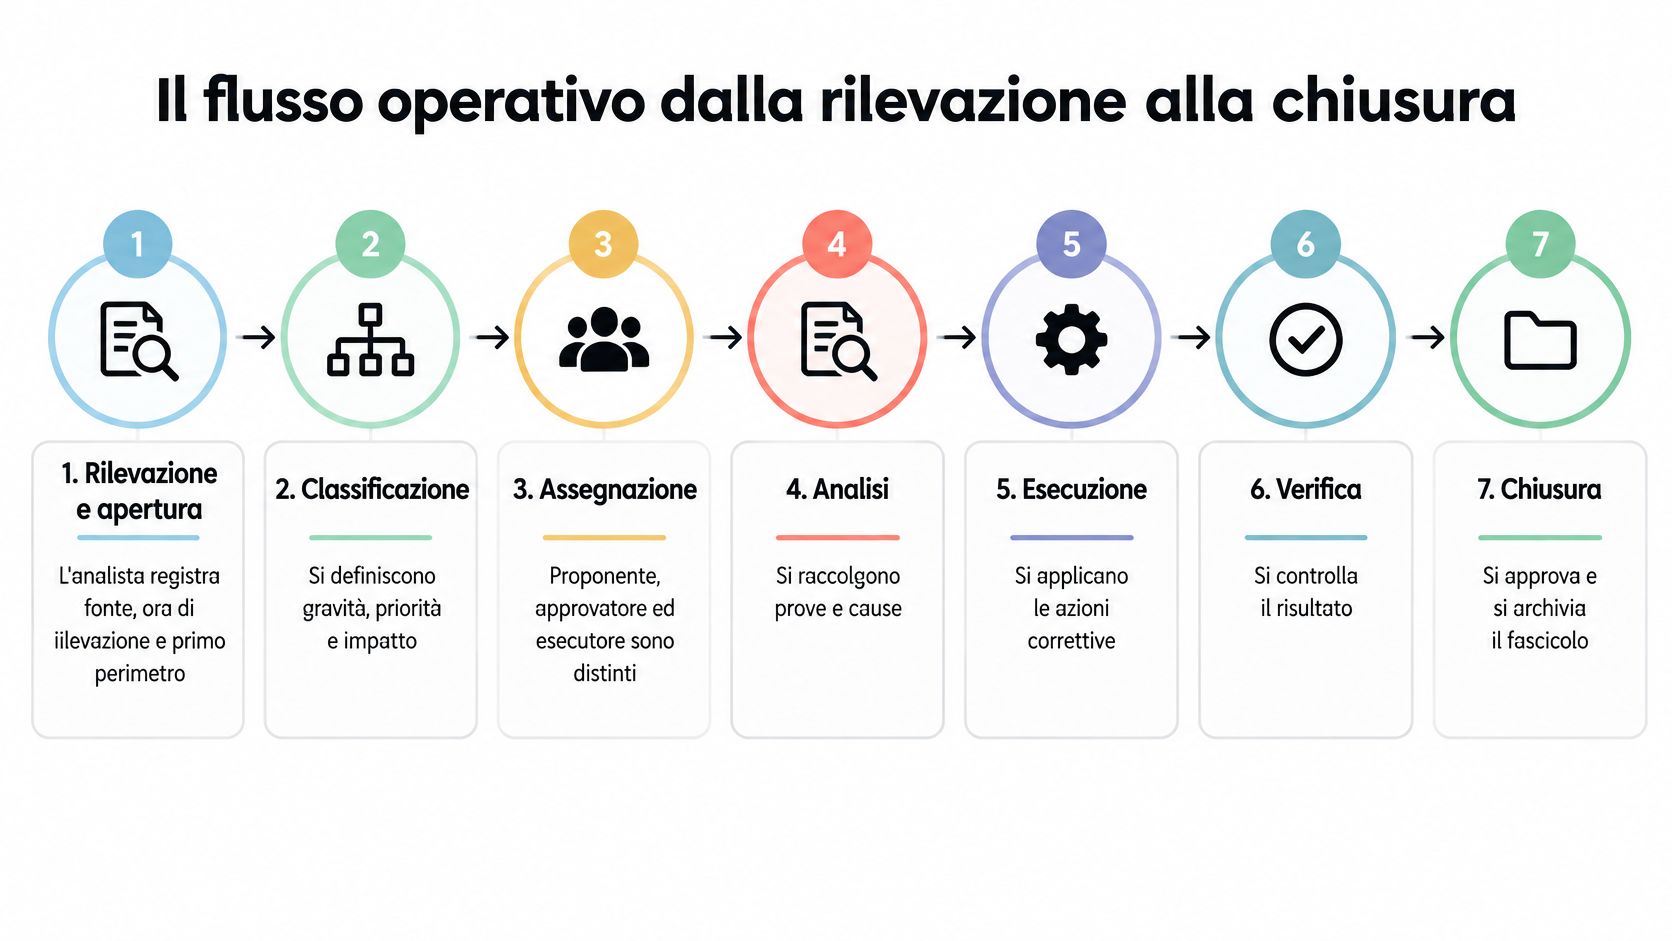
Sette fasi con responsabilità separate
- Rilevazione e apertura. L'analista registra fonte, ora di rilevazione, asset o processo coinvolto e primo perimetro. Questo dato fissa l'inizio della timeline e non deve coincidere automaticamente con l'ora di apertura del ticket.
- Triage e classificazione. Il responsabile incidenti conferma categoria, impatto e priorità, con verifica di un secondo ruolo quando la severità lo richiede. Fino alla conferma dell'impatto, il caso resta evento.
- Contenimento. L'owner del sistema o il fornitore incaricato esegue l'azione e allega la prova tecnica, per esempio log, modifica di configurazione o referto dell'intervento.
- Valutazione degli obblighi. Il referente compliance calcola le scadenze e prepara la comunicazione. Il DPO o il legale interno approva quando sono coinvolti dati personali o obblighi verso autorità.
- Ripristino e verifica. Chi ripristina il servizio documenta esito e controlli effettuati, mentre un ruolo indipendente verifica che il ripristino sia effettivo. La pratica resta aperta finché manca questa verifica.
- Analisi della causa radice. Il team distingue fatti confermati, ipotesi escluse e causa ritenuta più probabile. Ogni carenza rilevante genera un finding con severità, owner e scadenza.
- Chiusura con evidenza. La chiusura richiede timeline completa, eventuali ricevute di notifica, prova del ripristino e stato delle remediation. I casi chiusi vanno campionati periodicamente, perché una chiusura formalmente completa può nascondere una prova debole.
La segregazione più importante è semplice da enunciare e difficile da mantenere sotto pressione. La persona che contiene l'incidente non dovrebbe essere l'unica a dichiararlo risolto.
Io partirei dalla revisione dei casi chiusi nell'ultimo trimestre, applicando i criteri illustrati nella guida su come verificare l'efficacia delle attività di remediation. Se il sistema non consente di distinguere proponente, approvatore, esecutore e verificatore, il problema non si risolve aggiungendo campi liberi. Va corretto il workflow.
Scadenze di notifica e timestamp da conservare
Una scadenza è difendibile soltanto se il registro conserva istante iniziale, regola applicata, calcolo, invio e ricevuta. La sola data del ticket non dimostra quando l'organizzazione ha rilevato il fatto né quando ne ha conosciuto l'impatto.
| Quadro | Scadenza di riferimento | Dati da conservare |
|---|---|---|
| NIS2, incidenti con impatto sui beni ICT | 1 o 6 ore, in funzione della gravità | Ora di rilevazione, ora di classificazione, perimetro tecnico, motivazione |
| NIS2, altri sistemi informativi e di rete | 72 ore | Stessi dati, più comunicazioni successive e relative ricevute |
| DORA, criteri di rilevanza | Durata oltre 24 ore o indisponibilità oltre 2 ore per servizi che supportano funzioni critiche o importanti | Inizio, risoluzione, fonte del timestamp, incertezza sull'orario |
| DORA, stage di notifica | Iniziale, intermedia e finale, con termini da verificare sul regolamento delegato applicabile | Data di invio per ciascuno stage e motivazione di eventuali ritardi |
| GDPR, violazione di dati personali | Notifica al Garante senza ingiustificato ritardo e, ove possibile, entro 72 ore | Ora di conoscenza, valutazione del rischio, data di notifica |
Due esempi temporali
Le FAQ ACN su NIS e PSNC distinguono gli incidenti con impatto sui beni ICT, da notificare entro 1 o 6 ore in funzione della gravità, da quelli relativi ad altri sistemi informativi e di rete, da notificare entro 72 ore. Se un servizio ICT viene rilevato alle 09:10 e classificato alle 10:00, entrambi gli orari vanno conservati con la ragione dell'intervallo e il perimetro usato per scegliere il percorso.
Per un servizio interrotto dalle 14:00 alle 17:30, la durata dell'indisponibilità può incidere sulla rilevanza DORA. Se l'inizio viene ricostruito dai log, il fascicolo deve indicare la fonte, l'eventuale incertezza e chi ha validato il calcolo. In AuditReady registriamo gli incidenti ICT operativi con profilo DORA, stato e stage di notifica iniziale, intermedia e finale.
Per il GDPR, il registro deve conservare separatamente il momento della conoscenza e la valutazione del rischio per gli interessati, in coerenza con la procedura per il data breach entro 72 ore. Gli stage e i termini DORA vanno verificati sul regolamento delegato applicabile prima di codificarli come regole automatiche.
Criteri per scegliere e verificare una piattaforma
Il criterio decisivo cambia con il modello operativo. Una piattaforma adatta a un SOC interno può essere inutilizzabile per una PMI che dipende da un MSP, mentre un registro semplice può fallire quando entrano whistleblowing, OdV o più clienti. La demo va quindi costruita su un caso rappresentativo, non su dati dimostrativi generici.
| Situazione | Criterio decisivo | Prova da chiedere in demo |
|---|---|---|
| Team interno con SOC | Integrazione con SIEM ed EDR e deduplicazione degli alert | Stesso alert importato due volte con un solo caso aperto e fonte conservata |
| PMI senza SOC 24/7 e con MSP | Raccolta documentale dai fornitori senza account | Invio di un documento tramite collegamento a scadenza e verifica del registro |
| Organizzazione con whistleblowing | Separazione tra canale riservato e registro di governance | Evento trasferito al Modello 231 senza testo della segnalazione |
| Consulente con più clienti | Separazione dei tenant e amministrazione centrale | Due clienti simulati con accessi che non si vedono reciprocamente |
| Soggetto DORA | Calcolo della rilevanza e stage di notifica tracciati | Incidente simulato con timestamp, durata e invio per stage |
Verifiche che contano più dell'elenco funzioni
Per una PMI senza SOC continuo, il fornitore deve poter trasmettere log, referti e dichiarazioni tramite collegamenti sicuri a scadenza, senza creare account permanenti. Il sistema deve collegare ogni documento al caso e tracciare chi l'ha caricato e quando. Noi consentiamo questa raccolta dai fornitori senza account e manteniamo il documento nel contesto dell'evidenza richiesta.
Per i fornitori ICT è altrettanto importante sapere se forniscono servizi ICT, supportano una funzione critica, prevedono diritti di audit, hanno un piano di uscita documentato e dove sono localizzati i dati. Queste informazioni servono durante l'incidente per stabilire dipendenze, tempi di escalation e responsabilità, non soltanto in fase contrattuale.
Dove esiste un canale di whistleblowing secondo il D.Lgs. 24/2023, il registro incidenti non deve replicare testo, allegati o identità contenuti nella segnalazione. Al Modello 231 e all'OdV va trasferito soltanto l'evento di governance necessario, con accessi per ruolo e tracciamento delle visualizzazioni. Il nostro canale riservato applica questa separazione, perché il registro del Modello 231 riceve l'evento e non il testo della segnalazione.
Il consulente multi-cliente deve verificare separazione dei tenant, modelli riutilizzabili e amministrazione centrale senza visibilità incrociata. Il soggetto DORA deve invece provare che timestamp, durata, classificazione e stage restano collegati. In tutti i casi io misurerei il tempo alla prova documentale, cioè il tempo necessario per produrre una timeline verificabile da un caso chiuso.
Regola di selezione. Sostituire la checklist commerciale con un incidente simulato completo rende visibili subito ruoli mancanti, timestamp incoerenti ed evidenze non esportabili.
Nessuna piattaforma certifica la conformità o sostituisce la consulenza legale. Può rendere più difficile perdere contesto, attribuzioni e prove, ma owner e approvatori restano responsabili delle decisioni registrate.
Errori comuni che indeboliscono l'audit
Gli errori più costosi non sembrano gravi durante la risposta. Diventano gravi quando l'auditor chiede di dimostrare coerenza tra log, decisioni e chiusure.
| Errore | Cosa succede in audit | Correzione |
|---|---|---|
| Approvazioni retroattive | Chiusura approvata dopo l'audit con data successiva all'evento | Approvazione datata e registro delle modifiche |
| Eccezioni rinnovate all'infinito | Deroga prorogata più volte senza rivalutazione del rischio residuo | Scadenza fissa e motivazione aggiornata a ogni rinnovo |
| Evidenze sparse | La prova è in e-mail, chat e cartelle personali | Un unico fascicolo collegato al caso |
| Chiusure non verificate | Il ticket dice risolto, ma nessun ruolo indipendente ha controllato | Verifica da parte di un ruolo diverso da chi ha eseguito |
| Screenshot senza timestamp | Un'immagine che non dimostra data né fonte | Esportazione con metadati e hash |
| Timeline ricostruita a memoria | Orari incoerenti tra ticket e log | Timestamp di sistema come riferimento unico |
| Software come sostituto della responsabilità | Il tool registra, ma nessuno decide | Owner nominato per ogni caso |
L'approvazione retroattiva danneggia anche un incidente gestito bene, perché introduce il dubbio che altre date siano state ricostruite. Il sistema deve conservare autore, data originale e modifiche successive, distinguendo correzione materiale e nuova decisione.
Le evidenze sparse producono un effetto simile. Se il log si trova in una cartella personale, la decisione in chat e la ricevuta in una mailbox condivisa, il fascicolo dipende dalla disponibilità delle persone. L'esportazione deve invece includere il documento o un riferimento stabile, con versione e integrità verificabile.
L'errore meno visibile è trattare lo strumento come responsabile del processo. Un workflow può impedire una chiusura senza evidenza, ma non può decidere se il rischio residuo è accettabile. Quella scelta richiede un owner nominato, motivazione e data di revisione.
Domande frequenti
Un alert chiuso come falso positivo va registrato
Sì. Va chiuso come evento, con motivazione, evidenza esaminata, data e secondo verificatore quando la procedura lo prevede. Eliminarlo senza traccia impedisce di dimostrare che il triage sia stato eseguito e rende impossibile individuare alert ricorrenti scartati in modo incoerente.
Il fornitore MSP può chiudere un incidente per l'organizzazione
Può eseguire il contenimento, allegare log e dichiarare il ripristino tecnico. La chiusura deve però essere approvata da un ruolo interno responsabile del sistema o del processo. L'attività può essere affidata al fornitore, la responsabilità della decisione no.
Quando un evento diventa incidente notificabile
Quando l'impatto è confermato e risultano soddisfatti i criteri del quadro applicabile, per esempio NIS2, DORA o GDPR. Il registro deve conservare data di conferma, motivazione, dati usati per la scadenza e approvazione, perché l'auditor verificherà anche gli eventi esclusi dalla notifica.
Un'eccezione può trasformarsi in finding
Sì, se scade senza chiusura, se viene rinnovata senza nuova valutazione o se il controllo compensativo non è stato verificato. Eccezione e finding restano in registri distinti, collegati tra loro, così da distinguere la deroga autorizzata dalla carenza successivamente accertata.
Gli IoC ricevuti da fonti istituzionali sono evidenze complete
No. Vanno conservati con fonte, data di ricezione, versione e timestamp, ma restano indicatori tecnici. Diventano evidenze utilizzabili nel fascicolo quando sono collegati a un asset, a una ricerca documentata e a un'azione di contenimento o esclusione verificata.
Verificare il registro prima del prossimo audit
La verifica più utile parte dall'ultimo incidente chiuso. Bisogna ricostruire la timeline usando soltanto il sistema, senza intervistare le persone coinvolte e senza cercare documenti in mailbox o chat. Il tempo impiegato e le informazioni mancanti indicano la qualità reale del registro.
Sei domande di controllo
- Ogni incidente ha owner, categoria motivata e ora di rilevazione conservata?
- Ogni notifica mostra scadenza calcolata, data di invio e ricevuta?
- Ogni approvazione è datata e l'autore non coincide con chi ha eseguito l'azione?
- Ogni finding ha severità, scadenza e prova di chiusura verificata?
- Ogni eccezione indica motivazione, rischio residuo e termine non rinnovato senza revisione?
- La timeline può essere esportata senza ricostruzioni manuali o integrazioni a memoria?
Per ciascun caso devono essere presenti i campi minimi del registro, ossia identificativo, owner, asset o processo, categoria motivata, scadenza, rischio residuo, controlli compensativi e prova di chiusura. Se uno di questi elementi richiede una ricerca fuori dal sistema, il fascicolo non è ancora pronto per una review indipendente.
Io chiuderei la prova cronometrando l'esportazione di un evidence pack completo e facendo verificare il risultato a una persona che non ha gestito l'incidente. Il suo compito non è giudicare la risposta tecnica, ma stabilire se ruoli, orari, decisioni e documenti reggono senza spiegazioni orali.
Con AuditReady potete collegare incidenti, controlli, finding, remediation ed evidenze versionate in un unico fascicolo esportabile per la review. Visitate AuditReady per verificare sul vostro processo come ridurre il tempo necessario a produrre una timeline difendibile, mantenendo decisioni e responsabilità in capo ai ruoli interni.